Universidad Nacional de Ingeniería
Facultad de Ingeniería Industrial y de Sistemas · Unidad de Posgrado
Maestría en Inteligencia Artificial
Curso MIA-14 · Trabajo de Investigación II · Ciclo 2026-2 · Sección B

Sprint 1 · Pipeline reproducible, EDA y baseline mínimo

Detección de eventos adversos en epicrisis de MIMIC-IV, como base para la priorización con la Matriz del Modelo GEMSES.

AlumnoCarlos Pérez Pérez
DocenteDr. Ing. Glen Dario Rodríguez Rafael
CursoMIA-14 Trabajo de Investigación II (en el sílabo: Proyecto de Investigación II, MIA-403)
ProgramaMaestría en Inteligencia Artificial · FIIS-UNI
FechaDemo interna del Sprint 1 · semana 3 · viernes 2 de octubre de 2026
Recorrido del repositorio · entregable de la semana 3

Qué contiene el repositorio y en qué orden revisarlo

github.com/carlosperez100/mia14-trabajo-investigacion-ii-tesis-gemses-mimic · organizado según el repo de ejemplo del curso

Carpeta / archivoContenido
README.mdAutores, dataset (fuente, registros, variables, fecha y SHA-256), ejecución y resultados
data/raw · interim · processed vacías en git por el DUA; bitácora de datos con hash
src/ingesta → preprocesado → baseline, más el orquestador run_pipeline.py
notebooks/EDA: calidad, riesgos y decisiones accionables
logs/log por etapa y metrics_baseline.txt
config/semilla 42, split e hiperparámetros
reportes/ · slides/resultados JSON, figuras y esta presentación
entregables/semana 2, roadmap y guion de la demo
Issues · Milestonestareas con responsable y plazo (Sprints 1 y 2)

Orden sugerido de revisión

  1. README: proyecto, dataset y hash
  2. Carpetas: estructura mínima del curso
  3. Cómo ejecutar: python src/run_pipeline.py
  4. logs/metrics_baseline.txt: métricas, semilla, split y verificación
  5. Notebook EDA: 3 decisiones para el Sprint 2
  6. Resultados e Issues: PR-AUC y tareas

Requisitos: requirements.txt con versiones exactas, .env.example con las rutas y ninguna ruta absoluta en el código.

Las láminas siguientes explican cada parte
El problema y la tarea

¿La nota de alta corresponde a una hospitalización con un evento adverso?

Unidad de análisis

Una epicrisis (discharge summary) de MIMIC-IV-Note v2.2.

Variable objetivo

Binaria. Positiva si la hospitalización tiene un código CIE de semántica causal explícita (estrato A1). Es supervisión débil.

Partición

Por paciente (GroupShuffleSplit, 80/20, semilla 42): ningún paciente aparece en train y test a la vez.

Por qué importa la métrica

El test tiene 53.7 % de positivas, así que un dummy que siempre dice «sí» obtiene F1 = 0.698. Por eso la métrica central es la PR-AUC (cuyo piso es 0.537), junto con F1 de la clase positiva y Recall. Como la prevalencia real en MIMIC-IV es 20.12 % (109 775 de 545 497 hospitalizaciones), también se reporta el VPP corregido por Bayes.

Fuente de cifras: reportes/preprocesado_resumen.json2 / 11
Punto de partida · Track A con pipeline previo no reproducible

Había un modelo entrenado, pero no se podía repetir

Antes del sprint (julio 2026)

  • 46 scripts, uno por fase, sin orquestador
  • Rutas absolutas escritas en el código
  • Partición train/test no guardada
  • Versiones de librerías sin fijar
  • Sin baseline mínimo sobre el corpus corregido

Cumple la definición de «sprint defectuoso» del sílabo: código que no reproduce, splits no guardados, pipeline no reproducible.

Objetivo medible del Sprint 1

Que un tercero con credencial PhysioNet clone el repositorio, ejecute python src/run_pipeline.py y obtenga:

  • el mismo corpus y la misma partición;
  • las cifras del modelo de la tesis: sensibilidad 0.7623, especificidad 0.7699 y AUC 0.8426, con una tolerancia de ± 0.005.
entregables/sprint1/ROADMAP_SPRINT1.md3 / 11
Diseño del pipeline

Un comando, tres etapas, salidas trazables

1 · IngestaVerifica las fuentes, calcula SHA-256, copia las etiquetas a data/interim y extrae la época CIE.
→ bitacora_datos.csv
→
2 · PreprocesadoPositivos A1, negativos emparejados por época, texto, limpieza, submuestreo y partición por paciente.
→ dataset.parquet · splits.csv
→
3 · BaselineDos dummy, una logística TF-IDF y la referencia de la Fase 9. IC 95 % por bootstrap.
→ baseline_resultados.json · figura
+
EDANotebook orientado a riesgos: balance, confusor, atajos y fugas.
→ 01_EDA_sprint1.ipynb

Configuración

config/config.yaml guarda los parámetros y la semilla; .env guarda las rutas. En src/ no queda ninguna ruta absoluta.

Registro

Cada etapa deja un log con fecha en logs/ y conteos por paso.

Sin fuga

El TF-IDF se ajusta solo con train. La partición se lee de splits.csv.

src/run_pipeline.py --desde · --hasta · --sin-referencia4 / 11
Etapa 1 · Ingesta idempotente

Bitácora de datos: fuente, fecha, hash, tamaño

FuenteRolTamañoSHA-256 (inicio)
diagnoses_icd.csv.gz (MIMIC-IV v3.1)cruda, externa (DUA)33.6 MB47665a41b2a3ad99…
discharge.csv.gz (MIMIC-IV-Note v2.2)cruda, externa (DUA)1 139.2 MB27bc552edaf81c2a…
Etiquetas A1 · Tier A (fase 3 v2)copiada a interim10.8 MB778b9d3993c9e1c4…
Equivalencias CIE-10-CM (fase 8)copiada a interim3.1 MB1f130393a004a274…
Positivos CIE-9 (fase 7)copiada a interim4.0 MB4d481fbb48da4edb…
Época CIE por hospitalizaciónderivada2.6 MBa8b53ea73a9853ad…
Idempotente

La segunda ejecución no copia ni vuelve a calcular hashes: hay caché por tamaño y fecha.

DUA PhysioNet

MIMIC no se copia ni se versiona. Se registra su hash para demostrar que se usó el mismo archivo.

data/bitacora_datos.csv · logs/ingesta_*.log5 / 11
Etapa 2 · Preprocesado con conteos por paso

De 545 497 hospitalizaciones a 70 000 notas, sin pacientes compartidos

545 497 hospitalizaciones con diagnóstico
329 325 seleccionadas
109 775 positivas + 219 550 negativas emparejadas por época
213 974 notas con texto
0 descartadas por texto nulo o corto
70 000
notas finales · 37 692 positivas · 48 669 pacientes (techo por memoria)
55 915
notas de entrenamiento · 53.9 % positivas
14 085
notas de test · 53.7 % positivas
0
pacientes compartidos entre train y test

Verificación: el corpus reconstruido es idéntico nota por nota, en el mismo orden y con las mismas etiquetas que el de la Fase 9 de julio de 2026.

reportes/preprocesado_resumen.json · logs/preprocesado_*.log6 / 11
EDA orientado a riesgos

Cinco preguntas que podrían invalidar el modelo

RiesgoEvidenciaDecisión
Métrica engañosa por el balance53.8 % de positivas en el corpus frente a 20.12 % real; el dummy obtiene F1 = 0.698PR-AUC como métrica central, más F1 (+) y Recall
Confusor de época CIE-9 / CIE-1071.1 / 28.9 % en ambas clases; AUC de la época sola = 0.500Controlado
Atajo por largo de la notaMediana de 10 717 frente a 9 185 caracteres; AUC del largo solo = 0.606Moderado control en el Sprint 2
Fuga de códigos CIE en el textoFormato CIE-10 en 4.95 % de las positivas frente a 4.45 % de las negativasBajo; ablación en el Sprint 2
Fuga por paciente1.44 notas por paciente; 0 compartidosGroupKFold en el Sprint 2
Clases raras (etapa 2)Sistema/Organización: 130 notas (0.34 %)No evaluable; reportar aparte
notebooks/01_EDA_sprint1.ipynb (solo agregados, por el DUA)7 / 11
EDA · gráfico 1 · largo de la nota

Las notas más largas tienen más positivas
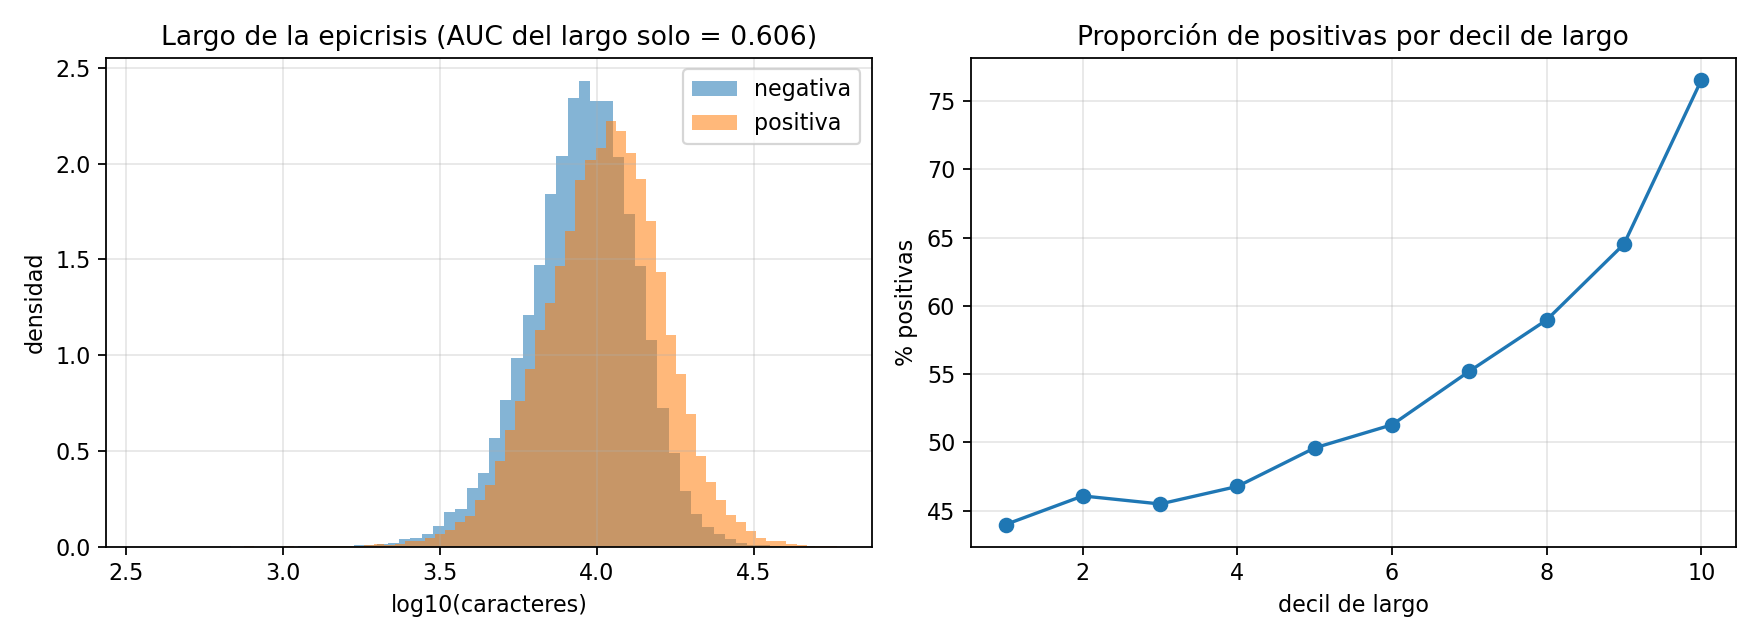
Histograma del largo de la epicrisis por clase y proporción de positivas por decil de largo
InterpretaciónA la izquierda, la distribución del largo de las epicrisis por clase (escala logarítmica): la curva naranja (con evento) está corrida a la derecha. A la derecha, el porcentaje de notas con evento en cada décimo del largo, de la más corta a la más larga.
AnálisisLas positivas son más largas: mediana de 10 717 frente a 9 185 caracteres. La proporción de positivas sube de forma continua, de 44.0 % en el decil más corto a 76.5 % en el más largo. El largo por sí solo separa las clases con un AUC de 0.606.
ConclusiónHay un riesgo moderado de atajo: el modelo podría aprender «nota larga = evento». Decisión para el Sprint 2: evaluar el modelo dentro de cada decil de largo y comprobar que mantiene su desempeño.
reportes/figuras/fig_eda_largo.png
EDA · gráfico 2 · correlaciones simples

Ninguna variable de contexto explica la etiqueta por sí sola
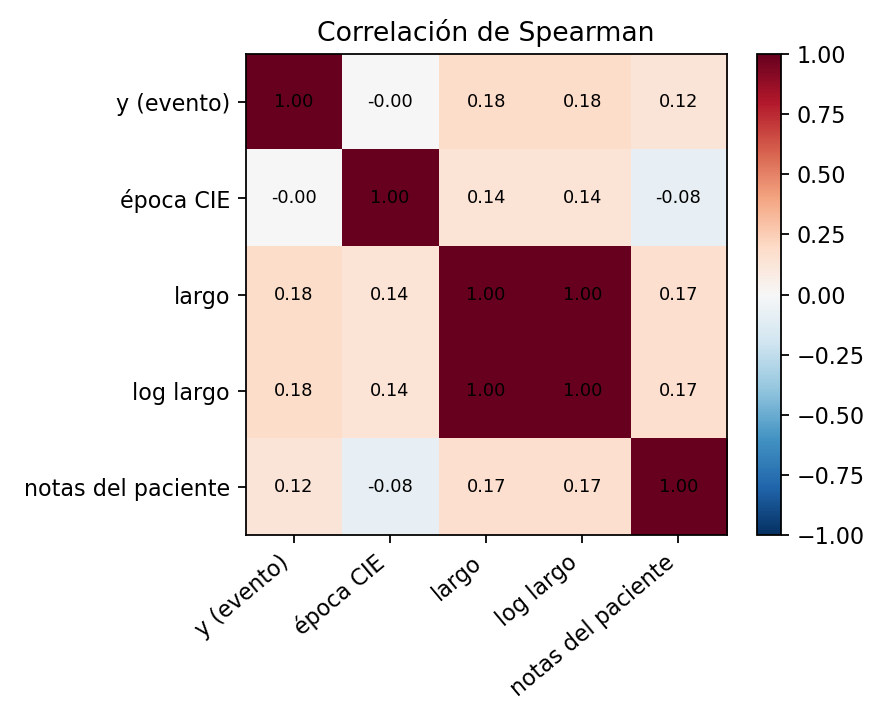
Matriz de correlación de Spearman entre la etiqueta, la época CIE, el largo y las notas por paciente
InterpretaciónCorrelación de Spearman entre la etiqueta (evento sí/no) y tres variables de contexto que no son el contenido clínico: la época de codificación CIE, el largo de la nota y el número de notas del paciente. Va de −1 a 1; cerca de 0 significa sin relación.
AnálisisLa época tiene correlación 0.000 con la etiqueta: el emparejamiento funcionó. El largo (0.182) y las notas por paciente (0.125) tienen correlaciones débiles pero no nulas: los pacientes con más hospitalizaciones y notas más largas tienen algo más de eventos.
ConclusiónEl confusor de época que había inflado los resultados en la tesis está controlado. Las asociaciones débiles con el largo y con la cantidad de hospitalizaciones se vigilan como posibles atajos; la señal del modelo debe venir del contenido del texto.
reportes/figuras/fig_eda_correlaciones.png
Etapa 3 · Baseline mínimo (test, partición por paciente)

El piso, un modelo simple y el modelo de la tesis

ModeloPR-AUCF1 (+)RecallROC-AUC (IC 95 %)VPP real
Dummy (más frecuente)0.5370.6981.0000.5000.201
Dummy (estratificado)0.5410.5500.5550.510 (0.501–0.518)0.207
Regresión logística TF-IDF0.8790.7910.7710.864 (0.858–0.869)0.485
Referencia tesis (LinearSVC)0.8610.7780.7620.843 (0.836–0.848)0.455
InterpretaciónCuatro modelos sobre las mismas 14 085 notas de test. La PR-AUC es la métrica central; F1 (+) y Recall miden la clase «con evento». El VPP real es la probabilidad de que una alerta sea un evento verdadero, con la prevalencia real de 20.12 %.
AnálisisLos dos dummy marcan el piso: PR-AUC de 0.54, que es la proporción de positivas del test. El dummy más frecuente obtiene F1 = 0.698 sin aprender nada, solo porque el test tiene 53.7 % de positivas. La logística supera al modelo de la tesis en todas las métricas, y sus intervalos de ROC-AUC no se solapan.
ConclusiónEl baseline simple supera al modelo de la tesis y entrena 9 veces más rápido (226 s frente a 1 980 s). Pasa a ser el modelo a batir en el Sprint 2. Con la prevalencia real, cerca de la mitad de las alertas serían verdaderas (VPP 0.485).
logs/metrics_baseline.txt · reportes/baseline_resultados.json
Baseline · gráfico 3 · curvas ROC y precisión-sensibilidad

La logística queda por encima en todo el rango
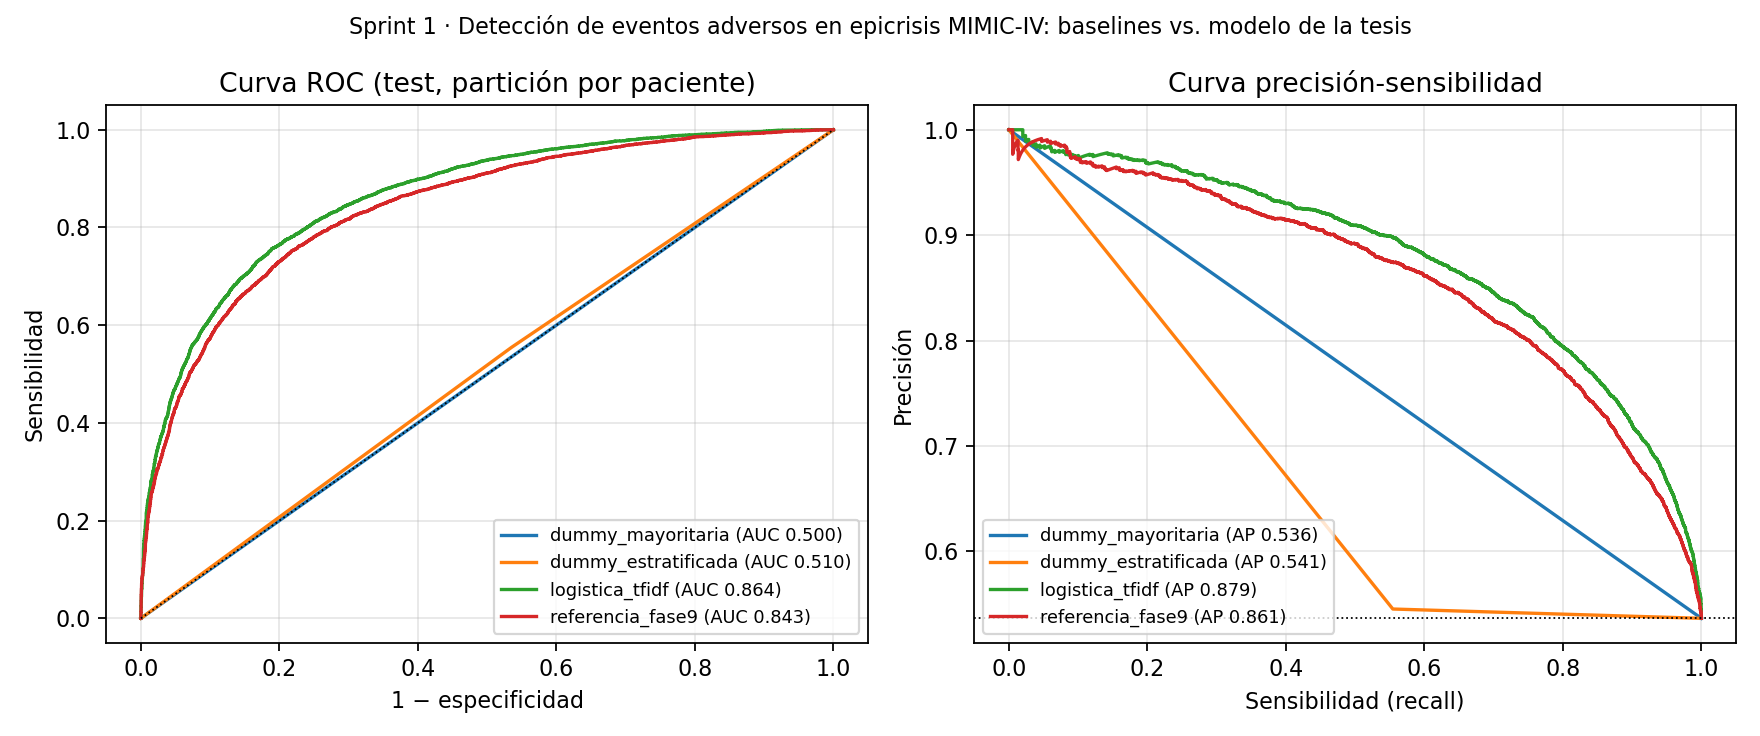
Curvas ROC y precisión-sensibilidad de los cuatro modelos
InterpretaciónCada curva muestra un modelo en todos sus umbrales posibles. En la ROC (izquierda), más arriba y a la izquierda es mejor; la diagonal es el azar. En la precisión-sensibilidad (derecha), más arriba es mejor; la línea punteada es la proporción de positivas (0.537).
AnálisisLos dos dummy siguen la diagonal y la línea de base: no discriminan. La logística (verde) queda por encima de la referencia de la tesis (roja) en ambas curvas: ROC-AUC 0.864 frente a 0.843 y PR-AUC 0.879 frente a 0.861.
ConclusiónLa mejora no es un efecto del umbral elegido: se ve en el área bajo ambas curvas, que resume todos los umbrales. El texto de la epicrisis contiene señal real del evento (PR-AUC 0.879 frente a un piso de 0.537).
reportes/figuras/fig_baseline_roc_pr.png
Baseline · gráfico 4 · cómo se equivoca cada modelo

Matrices de confusión en test
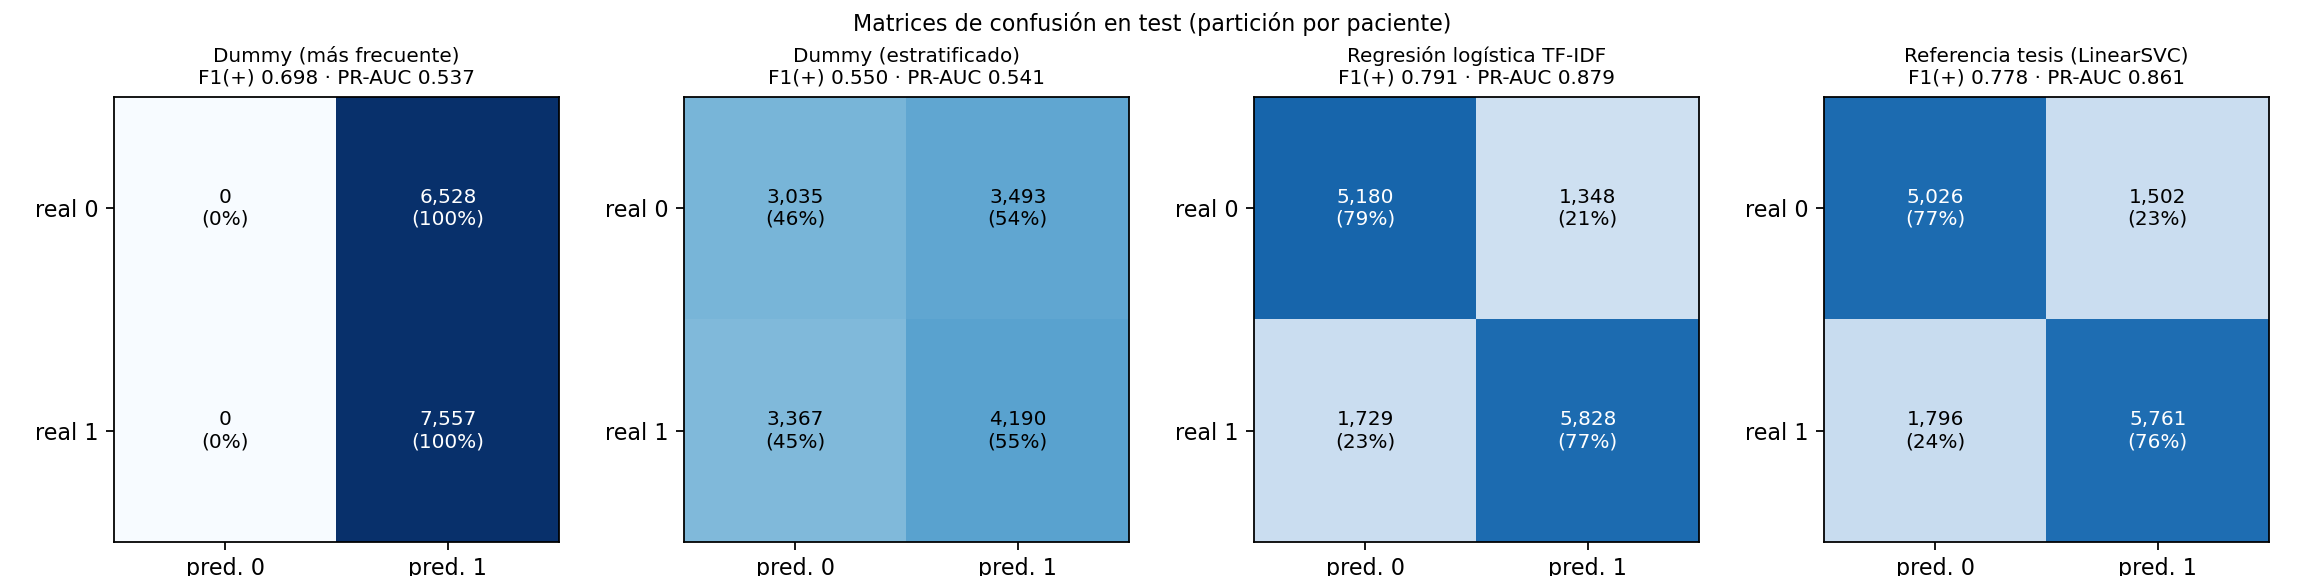
Matrices de confusión de los cuatro modelos en test
InterpretaciónFilas = realidad (0 sin evento, 1 con evento); columnas = predicción. La diagonal son los aciertos. Arriba a la derecha están los falsos positivos (alertas sin evento); abajo a la izquierda, los falsos negativos (eventos no detectados). El porcentaje es sobre cada fila.
AnálisisEl dummy más frecuente marca todo como evento: detecta el 100 % de los positivos y acierta el 0 % de los negativos. La logística acierta el 79 % de los negativos y detecta el 77 % de los eventos. Frente a la tesis tiene 154 falsos positivos menos (1 348 frente a 1 502) y 67 falsos negativos menos (1 729 frente a 1 796).
ConclusiónLa logística reduce los dos tipos de error a la vez. Aun así, el 23 % de los eventos reales no se detecta (1 729 de 7 557). Criterio profesional del autor: en vigilancia de seguridad del paciente el evento no detectado es el error más costoso, por lo que ajustar el umbral para subir la sensibilidad queda como tarea.
reportes/figuras/fig_matrices_confusion.png
Criterio de aceptación

Reproduce la Fase 9 con diferencia 0.0000

Sensibilidad

0.7623
esperado 0.7623 · diferencia 0.0000

Especificidad

0.7699
esperado 0.7699 · diferencia 0.0000

AUC

0.8426
esperado 0.8426 · diferencia 0.0000

Misma matriz de confusión que en julio

VN 5 026 · FP 1 502 · FN 1 796 · VP 5 761

Hallazgo para la tesis

El baseline simple (logística) supera al modelo de la tesis, y sus IC 95 % de AUC no se solapan. La causa todavía no está probada: es una hipótesis para el Sprint 2.

baseline_resultados.json → verificacion_reproducibilidad · tolerancia ± 0.00510 / 11
Límites declarados y Sprint 2

Lo que falta y lo que sigue

Límites de este sprint

  • Las tablas de etiquetas (fases 3 v2, 8 y 7) entran como archivos registrados con hash; todavía no se regeneran desde MIMIC dentro del orquestador.
  • La etiqueta es débil (códigos de facturación). El panel experto es la validación secundaria.
  • Una sola partición train/test; todavía no hay validación cruzada.

Sprint 2 (semanas 4–6)

  • Integrar las fases 3 v2, 8 y 7 al orquestador
  • GroupKFold por paciente, con resultados por fold
  • Control del atajo por largo y ablación con códigos CIE enmascarados
  • La logística pasa a ser el baseline a batir

Reproducir

pip install -r requirements.txt
cp .env.example .env          # MIMIC_DIR, MIMIC_NOTE_DIR, ETIQUETAS_DIR
python src/run_pipeline.py    # ingesta → preprocesado → baseline (~45 min en CPU)
github.com/carlosperez100/mia14-trabajo-investigacion-ii-tesis-gemses-mimic11 / 11